
Ce qu’il faut retenir :
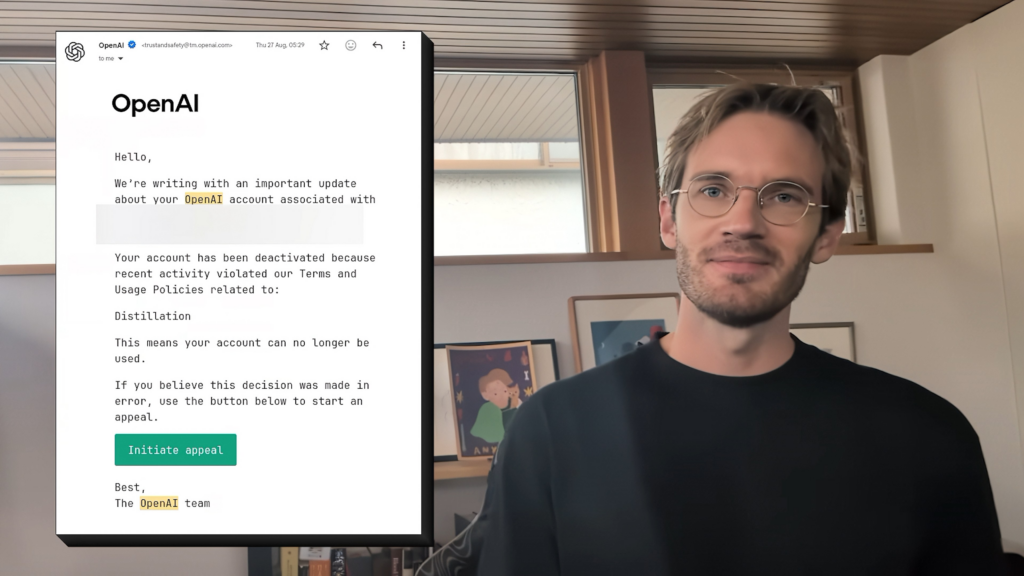
- OpenAI a banni deux fois le compte de PewDiePie pour avoir distillé ses réponses afin d’entraîner un modèle local.
- Le youtubeur développe Ajax, un modèle de 9 milliards de paramètres dérivé de Qwen3.5 d’Alibaba.
- Les conditions d’utilisation d’OpenAI interdisent d’exploiter ses réponses pour développer des modèles concurrents.
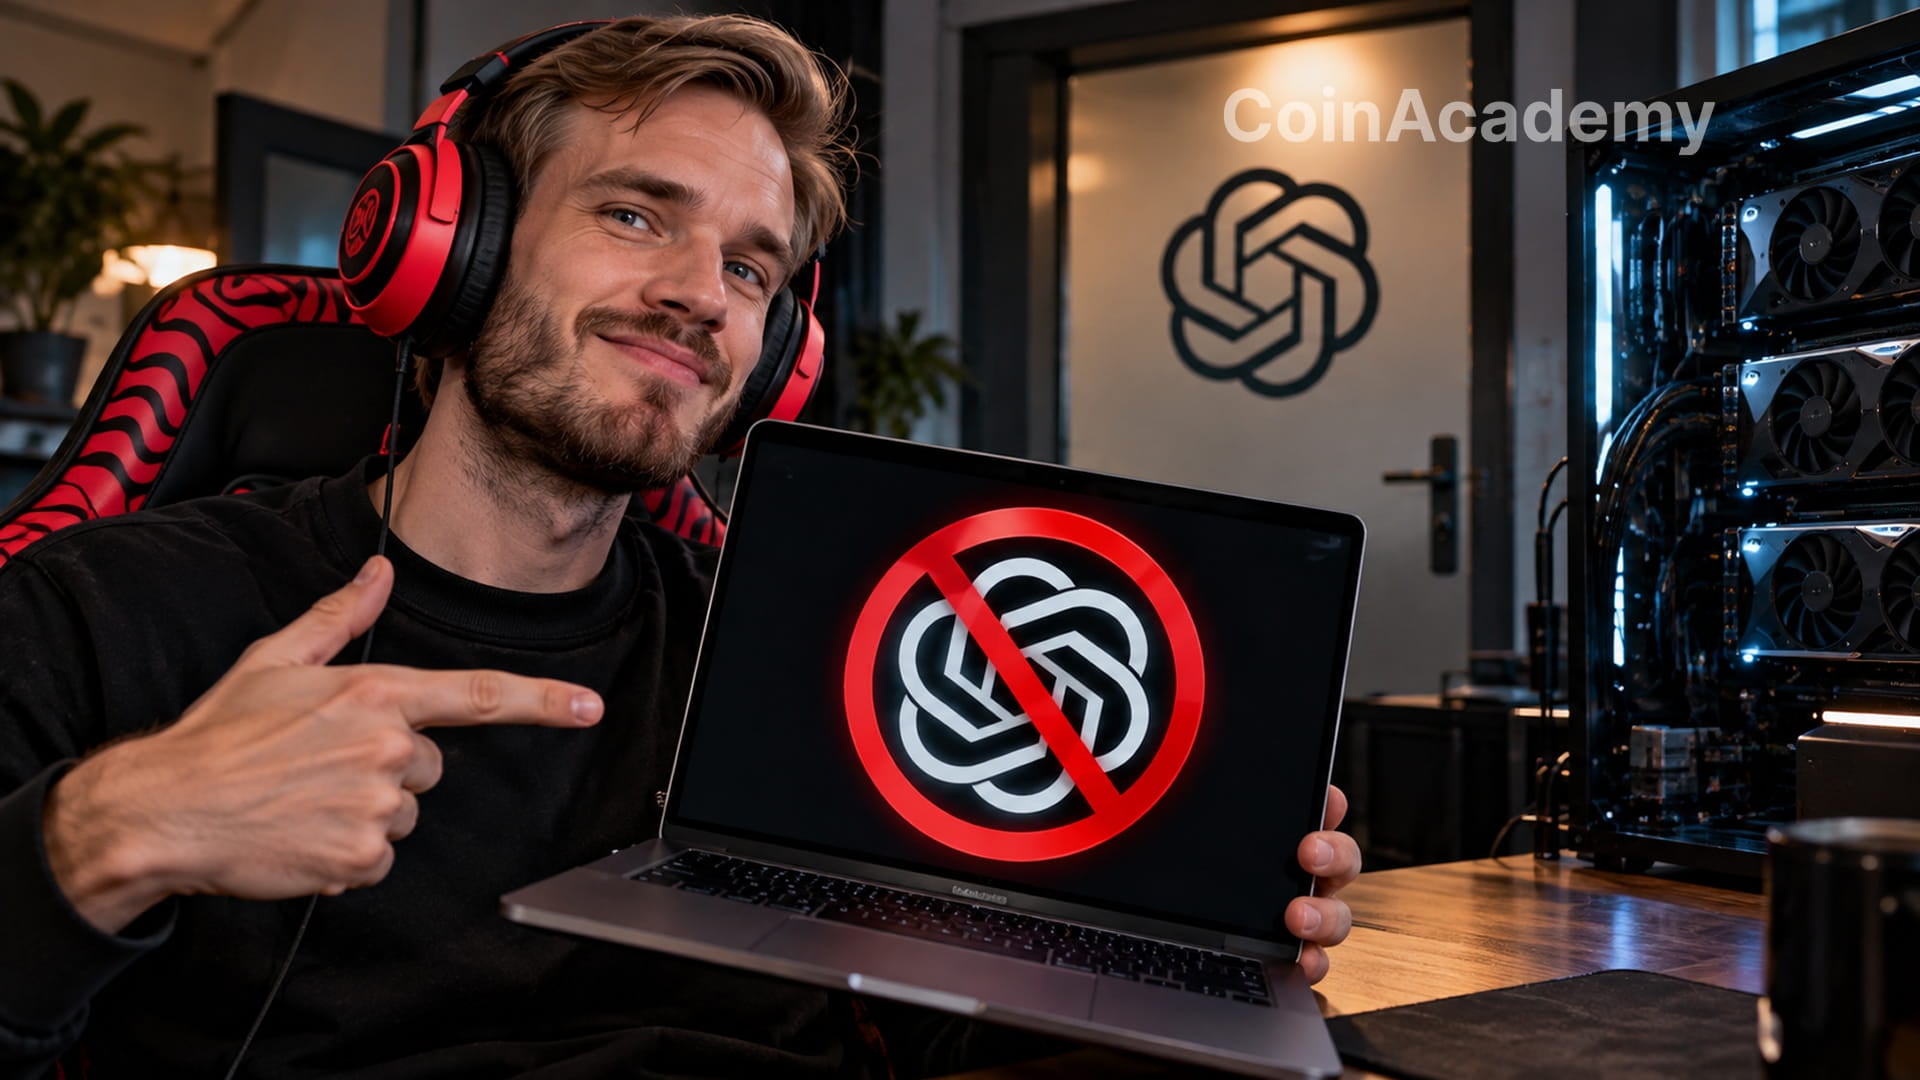
Felix Kjellberg, alias PewDiePie, a perdu deux fois l’accès à son compte OpenAI pour la même raison : la distillation. Le youtubeur suédois aux quelque 109 millions d’abonnés utilisait l’API de l’entreprise pour générer des données d’entraînement destinées à son propre modèle d’IA locale. Banni une première fois, il a fait appel, récupéré son compte, puis relancé la génération de données. Le second bannissement est tombé dans la foulée.
Dans sa vidéo, il affiche l’e-mail d’OpenAI qui cite la distillation comme motif, puis pose la question qui inquiète aujourd’hui de nombreux développeurs : « Comment ont-ils seulement su ? »
Ajax : le modèle d’IA locale de PewDiePie
Le projet s’appelle Ajax. Il s’agit d’un modèle de 9 milliards de paramètres, affiné à partir de Qwen3.5, le modèle open-weight d’Alibaba. Un modèle open-weight, c’est-à-dire dont les poids sont publiés et téléchargeables, peut tourner sur une machine personnelle sans passer par le cloud. Ajax tient sur une bonne carte graphique grand public.
Kjellberg l’intègre à Odysseus, son espace de travail auto-hébergé. Le modèle y gère ses e-mails, son agenda et ses recherches web, sans dépendre d’un serveur tiers.
Pour rendre Ajax utile au quotidien, le youtubeur a aussi réduit sa tendance à refuser des requêtes. Il a utilisé Heretic, un outil open source qui repère dans les poids du modèle les directions internes associées au refus, puis les atténue. Kjellberg baptise ce procédé « abliteration » et le compare à une opération du cerveau, avec un prix à payer : le modèle perd un peu de cohérence et de fiabilité. Sur les conseils de son avocat, Ajax refuse toujours de fournir des instructions dangereuses pour autrui ou pour l’utilisateur lui-même.
Pourquoi OpenAI a-t-il banni PewDiePie ?
La distillation consiste à entraîner un modèle avec les réponses d’un autre, plus puissant. La pratique est courante : beaucoup de petits modèles acquièrent ainsi des capacités de raisonnement sans engloutir des milliards de dollars en calcul. Les conditions d’utilisation d’OpenAI interdisent d’exploiter les réponses de ses modèles pour développer des modèles concurrents, tout comme le contournement de ses protections techniques.
Le texte ne prévoit aucune exception pour les amateurs. Un modèle de 9 milliards de paramètres ne menace pas les systèmes de pointe d’OpenAI, mais l’entreprise reste seule juge de ce qui constitue un concurrent.
Côté serveur, un créateur qui alimente un petit modèle personnel ressemble à une opération organisée. OpenAI combat une campagne qu’il attribue à des acteurs liés à Moonshot AI, une start-up chinoise. Les opérateurs copiaient des blocs de raisonnement chiffrés d’une conversation pour demander au modèle, dans une autre, de les décoder. Selon OpenAI, l’opération a culminé à 16 000 requêtes en deux jours, émises par plus de 4 000 utilisateurs. Aucun élément ne confirme que PewDiePie ait tenté une manœuvre de ce type.
Le raisonnement étape par étape, ou chaîne de pensée (chain-of-thought), constitue la donnée la plus précieuse des laboratoires d’IA. Il apprend à un modèle élève comment réfléchir, en plus de quoi répondre. Coûteux à produire, il fournit aussi à un concurrent la matière d’entraînement la moins chère qui soit. OpenAI chiffre donc ces jetons de raisonnement et ne livre que des résumés. Ses systèmes de détection réagissent au même signal dans tous les cas : un usage de l’API qui ressemble à l’entraînement d’un modèle.
IA chinoise et distillation : le dossier remonte à Washington
L’affaire tombe en plein débat politique. Garry Tan, PDG de l’accélérateur Y Combinator, plaide pour un régime américain de distillation qui autoriserait les laboratoires open-weight nationaux à s’entraîner sur les réponses des modèles de pointe. Son argument : ces laboratoires n’ont demandé à personne l’autorisation d’aspirer le web, ils ne devraient pas dicter l’usage des réponses de leurs modèles.
La Maison Blanche aborde la distillation étrangère sous l’angle de la sécurité nationale. Des propositions visent même à bannir les modèles open-weight chinois des plateformes américaines. Le hic : ces modèles s’imposent comme le choix par défaut des adeptes de l’IA locale. D’après les estimations relayées par la presse spécialisée, les modèles chinois traitent entre 30 % et 46 % du trafic de jetons des API d’entreprise sur les plateformes américaines, contre 4,5 % début 2025. Ajax lui-même repose sur un modèle d’Alibaba.
Un coup de projecteur inespéré pour l’IA locale
En voulant faire respecter ses règles, OpenAI a offert une vitrine géante aux modèles ouverts. Sur le forum Reddit r/LocalLLaMA, de nombreux utilisateurs y voient une publicité gratuite auprès de millions de personnes. D’autres pointent l’ironie : OpenAI a entraîné ses modèles sur le web public sans demander la permission, puis bannit un utilisateur qui fait de même avec ses réponses.
Grâce à son audience, Kjellberg a présenté Ajax à un public que peu de lancements open-weight ont touché. Une partie de ses abonnés découvre qu’un modèle de 9 milliards de paramètres tourne sur une carte graphique grand public.
Pour les développeurs, l’épisode a une portée pratique. Construire un produit sur l’API d’un tiers revient à hériter de ses conditions d’utilisation comme d’un risque d’entreprise, selon une analyse de Startup Fortune. Un bannissement soudain coupe l’accès et peut faire tomber le produit avec lui.
Ce qu’il faut surveiller
Kjellberg continue de développer Ajax et Odysseus. Les poids d’Ajax sont publiés : des testeurs indépendants pourront vérifier jusqu’où le modèle accepte d’aller une fois ses refus atténués. Côté régulation, Washington doit encore trancher sur le sort des modèles open-weight chinois, dont dépend une large part de l’écosystème de l’IA locale.
Cet article vous a plu ? Recevez les prochains par email
Rejoignez +40 000 abonnés. L'essentiel du marché crypto dans votre boîte mail, tous les 2 jours.